第一方数据 · 2026-08-28 至 09-05 · 作者本机实测
实时翻译字幕的延迟,三条链路实测。
英文会议的实时中文字幕有四个该量的数:对方开口到第一个中文字(中文首字)、对方说完到中文定稿(句尾到定稿)、定稿之后又改了几次(每句回改)、屏幕上多快有东西在动(英文速显)。在 Voice Translator(Mac)的三条字幕链路上,同一段音频量出来的是:豆包同传 2.0 中文首字 p50 2.85 s、句尾到定稿 0.70 s、回改 0.00;AssemblyAI + GLM 级联 3.17 s、1.45 s、0.77;端侧识别的英文逐词延迟 p50 1.26 s。2026 年 9 月 3 日一场 31 分钟的真实英文会议里,豆包链路读到中文首字 2.81 s、句尾到定稿 0.81 s、回改 0、英文速显 0.71 s,四项达标;建议上屏 4.2 s,没达标。
- 中文首字 p50 · 真会
- 2.81s
- 预算 ≤ 3 s
- 句尾 → 中文定稿 p50 · 真会
- 0.81s
- 预算 ≤ 2 s
- 每句回改 · 真会
- 0.00
- 只追加不回改
- 英文速显 p50 · 真会
- 0.71s
- 预算 ≤ 1.2 s
口径:五个数各量什么
| 指标 | 从哪到哪 | 预算 | 为什么重要 |
|---|---|---|---|
| 中文首字 | 对方开口(音频)→ 第一个中文字上屏 | ≤ 3 s | 你多久开始看懂 |
| 句尾 → 中文定稿 | 对方说完 → 这句的中文定稿上屏 | ≤ 2 s | 轮到你之前你能不能看完 |
| 每句回改 | 定稿之后被改写的次数 | ≈ 0 | 字幕闪不闪,能不能边看边想 |
| 英文速显(词延迟) | 对方说出一个词 → 这个词出现在英文行 | ≤ 1.2 s | 屏幕上多快有东西在动 |
| 建议上屏 | 对方那句定稿 → 一句能开口的英文上屏 | ≤ 2.5 s | 轮到你时有没有话 |
三条链路,同一段音频
2026-08-29,App 真链路,同一段干净的英文会议样本按真实时间回放。豆包同传 2.0 自带中文,字幕不经大模型;级联是 AssemblyAI 识别英文、GLM 只追加不回改地译成中文。
| 指标 · p50 | 豆包同传 2.0 | AssemblyAI + GLM 级联 | 读法 |
|---|---|---|---|
| 中文首字 | 2.85 s | 3.17 s | 级联的 3.1 到 3.2 s 在 08-28 的首轮实验里就是这个数,是它的天花板:AssemblyAI 的中间结果大约 1.3 s 才来一次 |
| 句尾 → 中文定稿 | 0.70 s | 1.45 s | 豆包赢一倍 |
| 每句回改 | 0.00 | 0.77 | 豆包原生不回改;级联靠只追加策略把整句重写从 1.77 压到 0.85 |
| 英文中间结果 | 2.75 s | 0.96 s | 豆包输在英文小字,按短语整块提交;这一格后来由端侧速显盖住 |
多人抢话的样本(AMI 会议语料库 ES2002a 前 5 分钟,4 人):豆包 106 段全部成对,中文首字 2.33 s、句尾到定稿 0.94 s、回改 0.00。08-28 的级联首轮(AssemblyAI + 只追加翻译):英文中间结果 0.89 到 0.93 s,中文首字 3.10 到 3.21 s(p90 4.8 到 4.9 s),句尾到定稿 1.47 到 1.59 s。
| 端侧识别(本机,Apple 芯片)· 2026-08-30 · 三轮池化 498 词 | 结果 |
|---|---|
| 词延迟 p50 / p90 | 1.258 s / 2.37 s(单轮在 0.95 到 1.33 s 之间跳;目标 ≤ 1.2 s,压线未过) |
| 段首词 p50 | 1.173 s |
| 速显比豆包定稿早 | p50 2.07 s,24 段里 24 段在定稿前已有速显文本,每段恰好被替换 1 次 |
| 速显定稿的词错误率 | 0.126(速显可能有错,可信文本以定稿为准) |
一场真实会议:2026-09-03,31 分钟
豆包链路,641 段字幕(豆包按短语切,每段 p50 6 词),作者开口 19 次。这是产品第一次在真实会议里跑满全程,零降级。
| 指标 | 预算 | p50 | p90 | 判定 |
|---|---|---|---|---|
| 中文首字 | ≤ 3 s | 2.81 s | 4.46 s | 达标 |
| 句尾 → 中文定稿 | ≤ 2 s | 0.81 s | 1.13 s | 达标 |
| 每句回改 | ≈ 0 | 0.00 | — | 达标 |
| 英文速显(逐词) | ≤ 1.2 s | 0.71 s | 1.20 s | 达标,首次在真实会议上量到 |
| 豆包英文中间结果 | ≤ 1.5 s | 2.71 s | — | 没达标,已知;速显行盖住了它 |
| 建议触发 → 上屏 | ≤ 2.5 s | 4.20 s | 6.71 s | 没达标,所以模板句 0 秒先上 |
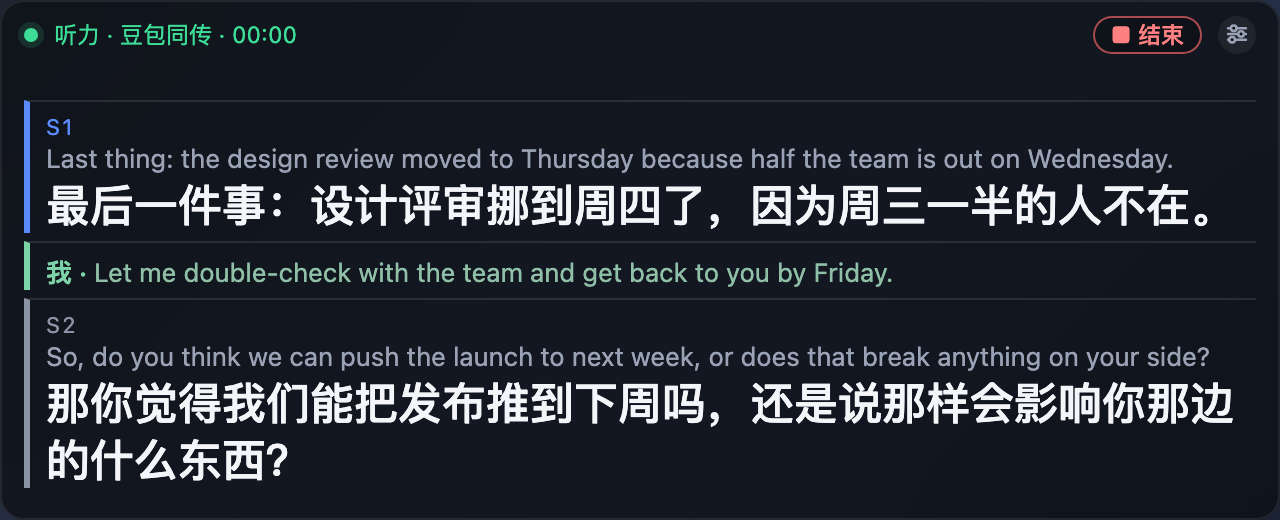
建议车道:唯一的红灯在模型那一跳
「对方说完 → 一句能开口的英文上屏」是全产品唯一没达预算的数。机制侧已经压到底(触发到发请求 0.60 s),剩下的几乎全是一次去北京的模型往返。
| 条件 | 建议上屏 p50 | 口径 |
|---|---|---|
| 云端 GLM · 真实信道 | 5.97 s | 2026-08-31 复盘,10 场里 10 场超预算 2.5 s |
| 云端 GLM · 真实会议 09-03 | 4.20 s | p90 6.71 s,max 20.4 s |
| 本机出口引擎(LM Studio 兼容接口) | 0.94 s | 假服务端口径,n=10;真实本机模型的数字待测 |
| 模板句(招式盘七格) | 0 s | 对方问完那一刻屏幕上已有一句能张嘴的话,具体句到了原地替换 |
谈与讲:另外两个姿势的数
谈 · iPhone · 全端侧乌克兰语 ↔ 中文链路 · 2026-09-05
- 说完 → 出声 p50 / p90
- 220 ms / 242 ms
- 乌克兰语识别 WER(FLEURS 100 句,Parakeet)
- 8.47%
- 中文识别 CER(FLEURS 100 句)
- 5.64%
- Apple 翻译 vs 云端 GLM 的 chrF++ 差
- 0.58 分
- 翻译里的数字 · 日期 · 金额丢失
- 0
- 念出来再听回去(TTS 回环)WER
- 11.49%,20 句里 5 句信息错
结论:本地链路进 M1 当兜底,不当默认;数字、日期、金额、人名走打字通道。详见 「谈」的七项验收。
讲 · 网页 · 白板链路本机跑通 · 2026-09-07 到 09-08 · GLM glm-5.3-flash
- 一段话 → 板上一个操作(十段)
- 中位 3 333 ms · 1 703–5 434 ms
- 操作类型与目标图判对
- 9 / 10
- 我这边发出 → 别人屏幕上画完(10 次)
- 中位 10 ms · 7–12 ms
- 三种语言的骨架抽掉文字后
- 逐字节相同
- 真实讲解
- 场次很少
「讲」2026-09-05 之前是一页纸原型,已整体下线,它的数字撤下了;现在这块板的实测与假设见 「讲」姿势页。
方法与出处
- 回放:同一段音频经回放器按真实时间灌给引擎,服务端按词级时间戳算每个口径,滚动 20 句取 p50;没有词级时间戳的引擎按句对齐。
- 真实会议:App 存档里的 metrics.jsonl,每句一条事件,不经人工挑选;这一场是 2026-09-03 的 31 分钟英文会议。
- 网络:从作者本机到北京的 TLS 握手 70 到 130 ms(2026-08-28 复测),不是延迟的大头。
- 公开数据集:AMI Meeting Corpus(ES2002a,多人会议);当面产品用 FLEURS 的乌克兰语与中文各 100 句。
- 界面上是同一份读数:Voice Translator(Mac)的状态行常驻本场的中文首字、句尾到定稿、速显三个 p50,官网和界面不会有两套数。
相关:会议实时翻译怎么选 · Mac 即时字幕怎么开 · 「听」姿势页
常见问题
关于这些数字。
为什么中文首字要 2.8 秒,英文速显却只要 1 秒?
豆包同传按大约六个词一个短语整块提交,中文首字的 2.81 秒几乎全是等它提交;端侧识别逐词吐字,所以英文速显 0.71 到 1.26 秒就有东西在动。两条线同时开着:速显先填进当前这一段的英文行,豆包定稿到了原地一次替换。
这些数字怎么复现?
回放实验用 AMI 会议语料库的 ES2002a 前 5 分钟和一段 67.7 秒的站会样本,按真实时间灌给引擎,服务端按词级时间戳算延迟;真实会议的数字直接读 App 存档里的 metrics.jsonl。App 界面状态行上常驻同一套读数,你自己开一场会就能对。
这页会更新吗?
会。每换一次引擎、每开一场有存档的真实会议,数字带日期追加在这一页;旧数字不删,标日期留着。没量过的写「待测」。